

תאריך פרסום: 2 בדצמבר 2022, תאריך עדכון אחרון: 29 באוקטובר 2026
' d='M96 183a64 64 0 0 1-23-23L17 64a128 128 0 0 0 111 192l55-96a64 64 0 0 1-87 23Z'/%3E%3Cpath fill='url(%23b)' d='M192 128a64 64 0 0 1-9 32l-55 96A128 128 0 0 0 239 64H128a64 64 0 0 1 64 64Z'/%3E%3Ccircle cx='128' cy='128' r='52' fill='%231a73e8'/%3E%3Cpath fill='url(%23c)' d='M96 73a64 64 0 0 1 32-9h111a128 128 0 0 0-222 0l56 96a64 64 0 0 1 23-87Z'/%3E%3C/svg%3E)
' xlink:href='%23A'%3E%3Cstop offset='.76' stop-opacity='0'/%3E%3Cstop offset='.95' stop-opacity='.5'/%3E%3Cstop offset='1'/%3E%3C/radialGradient%3E%3CradialGradient id='F' cx='2523' cy='4680' r='20243' gradientTransform='matrix(-.03715 .99931 -2.12836 -.07913 13579 3530)' xlink:href='%23A'%3E%3Cstop offset='0' stop-color='%2335c1f1'/%3E%3Cstop offset='.11' stop-color='%2334c1ed'/%3E%3Cstop offset='.23' stop-color='%232fc2df'/%3E%3Cstop offset='.31' stop-color='%232bc3d2'/%3E%3Cstop offset='.67' stop-color='%2336c752'/%3E%3C/radialGradient%3E%3CradialGradient id='G' cx='24247' cy='7758' r='9734' gradientTransform='matrix(.28109 .95968 -.78353 .22949 24510 -16292)' xlink:href='%23A'%3E%3Cstop offset='0' stop-color='%2366eb6e'/%3E%3Cstop offset='1' stop-color='%2366eb6e' stop-opacity='0'/%3E%3C/radialGradient%3E%3Cpath id='H' d='M24105 20053a9345 9345 0 01-1053 472 10202 10202 0 01-3590 646c-4732 0-8855-3255-8855-7432 0-1175 680-2193 1643-2729-4280 180-5380 4640-5380 7253 0 7387 6810 8137 8276 8137 791 0 1984-230 2704-456l130-44a12834 12834 0 006660-5282c220-350-168-757-535-565z'/%3E%3Cpath id='I' d='M11571 25141a7913 7913 0 01-2273-2137 8145 8145 0 01-1514-4740 8093 8093 0 013093-6395 8082 8082 0 011373-859c312-148 846-414 1554-404a3236 3236 0 012569 1297 3184 3184 0 01636 1866c0-21 2446-7960-8005-7960-4390 0-8004 4166-8004 7820 0 2319 538 4170 1212 5604a12833 12833 0 007684 6757 12795 12795 0 003908 610c1414 0 2774-233 4045-656a7575 7575 0 01-6278-803z'/%3E%3Cpath id='J' d='M16231 15886c-80 105-330 250-330 566 0 260 170 512 472 723 1438 1003 4149 868 4156 868a5954 5954 0 003027-839 6147 6147 0 001133-850 6180 6180 0 001910-4437c26-2242-796-3732-1133-4392-2120-4141-6694-6525-11668-6525-7011 0-12703 5635-12798 12620 47-3654 3679-6605 7996-6605 350 0 2346 34 4200 1007 1634 858 2490 1894 3086 2921 618 1067 728 2415 728 2952s-271 1333-780 1990z'/%3E%3Cuse fill='url(%23B)' xlink:href='%23H'/%3E%3Cuse fill='url(%23D)' opacity='.35' xlink:href='%23H'/%3E%3Cuse fill='url(%23C)' xlink:href='%23I'/%3E%3Cuse fill='url(%23E)' opacity='.4' xlink:href='%23I'/%3E%3Cuse fill='url(%23F)' xlink:href='%23J'/%3E%3Cuse fill='url(%23G)' xlink:href='%23J'/%3E%3C/svg%3E)
' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='.2' stop-color='%239059ff' stop-opacity='0'/%3E%3Cstop offset='.3' stop-color='%238c4ff3' stop-opacity='.1'/%3E%3Cstop offset='.8' stop-color='%237716a8' stop-opacity='.5'/%3E%3Cstop offset='1' stop-color='%236e008b' stop-opacity='.6'/%3E%3C/radialGradient%3E%3CradialGradient id='ff-g' cx='239.1' cy='34.6' r='171.6' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='0' stop-color='%23ffe226'/%3E%3Cstop offset='.1' stop-color='%23ffdb27'/%3E%3Cstop offset='.3' stop-color='%23ffc82a'/%3E%3Cstop offset='.5' stop-color='%23ffa930'/%3E%3Cstop offset='.7' stop-color='%23ff7e37'/%3E%3Cstop offset='.8' stop-color='%23ff7139'/%3E%3C/radialGradient%3E%3CradialGradient id='ff-h' cx='374' cy='-74.3' r='732.2' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='.1' stop-color='%23fff44f'/%3E%3Cstop offset='.5' stop-color='%23ff980e'/%3E%3Cstop offset='.6' stop-color='%23ff5634'/%3E%3Cstop offset='.7' stop-color='%23ff3647'/%3E%3Cstop offset='.9' stop-color='%23e31587'/%3E%3C/radialGradient%3E%3CradialGradient id='ff-i' cx='304.6' cy='7.1' r='536.4' gradientTransform='rotate(84 303 4)' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='0' stop-color='%23fff44f'/%3E%3Cstop offset='.1' stop-color='%23ffe847'/%3E%3Cstop offset='.2' stop-color='%23ffc830'/%3E%3Cstop offset='.3' stop-color='%23ff980e'/%3E%3Cstop offset='.4' stop-color='%23ff8b16'/%3E%3Cstop offset='.5' stop-color='%23ff672a'/%3E%3Cstop offset='.6' stop-color='%23ff3647'/%3E%3Cstop offset='.7' stop-color='%23e31587'/%3E%3C/radialGradient%3E%3CradialGradient id='ff-j' cx='235' cy='98.1' r='457.1' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='.1' stop-color='%23fff44f'/%3E%3Cstop offset='.5' stop-color='%23ff980e'/%3E%3Cstop offset='.6' stop-color='%23ff5634'/%3E%3Cstop offset='.7' stop-color='%23ff3647'/%3E%3Cstop offset='.9' stop-color='%23e31587'/%3E%3C/radialGradient%3E%3CradialGradient id='ff-k' cx='355.7' cy='124.9' r='500.3' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='.1' stop-color='%23fff44f'/%3E%3Cstop offset='.2' stop-color='%23ffe141'/%3E%3Cstop offset='.5' stop-color='%23ffaf1e'/%3E%3Cstop offset='.6' stop-color='%23ff980e'/%3E%3C/radialGradient%3E%3ClinearGradient id='ff-a' x1='446.9' y1='76.8' x2='47.9' y2='461.8' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='.1' stop-color='%23fff44f'/%3E%3Cstop offset='.1' stop-color='%23ffe847'/%3E%3Cstop offset='.2' stop-color='%23ffc830'/%3E%3Cstop offset='.4' stop-color='%23ff980e'/%3E%3Cstop offset='.4' stop-color='%23ff8b16'/%3E%3Cstop offset='.5' stop-color='%23ff672a'/%3E%3Cstop offset='.5' stop-color='%23ff3647'/%3E%3Cstop offset='.7' stop-color='%23e31587'/%3E%3C/linearGradient%3E%3ClinearGradient id='ff-l' x1='442.1' y1='74.8' x2='102.6' y2='414.3' gradientUnits='userSpaceOnUse'%3E%3Cstop offset='.2' stop-color='%23fff44f' stop-opacity='.8'/%3E%3Cstop offset='.3' stop-color='%23fff44f' stop-opacity='.6'/%3E%3Cstop offset='.5' stop-color='%23fff44f' stop-opacity='.2'/%3E%3Cstop offset='.6' stop-color='%23fff44f' stop-opacity='0'/%3E%3C/linearGradient%3E%3C/defs%3E%3Cpath d='M479 166c-11-25-32-52-49-60a249 249 0 0 1 25 73c-27-68-73-95-111-155a255 255 0 0 1-8-14 44 44 0 0 1-4-9 1 1 0 0 0 0-1 1 1 0 0 0-1 0c-60 35-81 101-83 134a120 120 0 0 0-66 25 71 71 0 0 0-6-5 111 111 0 0 1-1-58c-25 11-44 29-58 44-9-12-9-52-8-60l-8 4a175 175 0 0 0-24 21 210 210 0 0 0-22 26 203 203 0 0 0-32 73l-1 2-2 15a229 229 0 0 0-4 34v1a240 240 0 0 0 477 40l1-9c5-41 0-84-15-121zM202 355l3 1-3-1zm55-145zm198-31z' fill='url(%23ff-a)'/%3E%3Cpath d='M479 166c-11-25-32-52-49-60 14 26 22 53 25 72v1a207 207 0 0 1-206 279c-113-3-212-87-231-197-3-17 0-26 2-40-2 11-3 14-4 34v1a240 240 0 0 0 477 40l1-9c5-41 0-84-15-121z' fill='url(%23ff-b)'/%3E%3Cpath d='M479 166c-11-25-32-52-49-60 14 26 22 53 25 72v1a207 207 0 0 1-206 279c-113-3-212-87-231-197-3-17 0-26 2-40-2 11-3 14-4 34v1a240 240 0 0 0 477 40l1-9c5-41 0-84-15-121z' fill='url(%23ff-c)'/%3E%3Cpath d='m362 195 1 1a130 130 0 0 0-22-29C266 92 322 5 331 0c-60 35-81 101-83 134l9-1c45 0 84 25 105 62z' fill='url(%23ff-d)'/%3E%3Cpath d='M257 210c-1 6-22 26-29 26-68 0-80 41-80 41 3 35 28 64 57 79l4 2 7 3a107 107 0 0 0 31 6c120 6 143-143 57-186 22-4 45 5 58 14-21-37-60-62-105-62l-9 1a120 120 0 0 0-66 25l17 16c16 16 58 33 58 35z' fill='url(%23ff-e)'/%3E%3Cpath d='M257 210c-1 6-22 26-29 26-68 0-80 41-80 41 3 35 28 64 57 79l4 2 7 3a107 107 0 0 0 31 6c120 6 143-143 57-186 22-4 45 5 58 14-21-37-60-62-105-62l-9 1a120 120 0 0 0-66 25l17 16c16 16 58 33 58 35z' fill='url(%23ff-f)'/%3E%3Cpath d='m171 151 5 3a111 111 0 0 1-1-58c-25 11-44 29-58 44 1 0 36 0 54 11z' fill='url(%23ff-g)'/%3E%3Cpath d='M18 261a242 242 0 0 0 231 197 207 207 0 0 0 206-279c8 56-20 110-64 146-86 71-169 43-186 31l-3-1c-50-24-71-70-67-110-42 0-57-35-57-35s38-28 89-4c46 22 90 4 90 4 0-2-42-19-58-35l-17-16a71 71 0 0 0-6-5l-5-3c-18-11-52-11-54-11-9-12-9-51-8-60l-8 4a175 175 0 0 0-24 21 210 210 0 0 0-22 26 203 203 0 0 0-32 73c0 1-9 38-5 57z' fill='url(%23ff-h)'/%3E%3Cpath d='M341 167a130 130 0 0 1 22 29 46 46 0 0 1 4 3c55 50 26 121 24 126 44-36 72-90 64-146-27-68-73-95-111-155a255 255 0 0 1-8-14 44 44 0 0 1-4-9 1 1 0 0 0 0-1 1 1 0 0 0-1 0c-9 5-65 92 10 167z' fill='url(%23ff-i)'/%3E%3Cpath d='M367 199a46 46 0 0 0-4-3l-1-1c-13-9-36-18-58-15 86 44 63 193-57 187a107 107 0 0 1-31-6 131 131 0 0 1-11-5c17 12 99 39 186-31 2-5 31-76-24-126z' fill='url(%23ff-j)'/%3E%3Cpath d='M148 277s12-41 80-41c7 0 28-20 29-26s-44 18-90-4c-51-24-89 4-89 4s15 35 57 35c-4 40 16 85 67 110l3 1c-29-15-54-44-57-79z' fill='url(%23ff-k)'/%3E%3Cpath d='M479 166c-11-25-32-52-49-60a249 249 0 0 1 25 73c-27-68-73-95-111-155a255 255 0 0 1-8-14 44 44 0 0 1-4-9 1 1 0 0 0 0-1 1 1 0 0 0-1 0c-60 35-81 101-83 134l9-1c45 0 84 25 105 62-13-9-36-18-58-14 86 43 63 192-57 186a107 107 0 0 1-31-6 131 131 0 0 1-11-5l-3-1 3 1c-29-15-54-44-57-79 0 0 12-41 80-41 7 0 28-20 29-26 0-2-42-19-58-35l-17-16a71 71 0 0 0-6-5 111 111 0 0 1-1-58c-25 11-44 29-58 44-9-12-9-52-8-60l-8 4a175 175 0 0 0-24 21 210 210 0 0 0-22 26 203 203 0 0 0-32 73l-1 2-2 15a279 279 0 0 0-4 34v1a240 240 0 0 0 477 40l1-9c5-41 0-84-15-121zm-24 13z' fill='url(%23ff-l)'/%3E%3C/svg%3E)

' xlink:href='%23s-b'%3E%3Cstop offset='0' stop-color='%2324a5f3' stop-opacity='0' /%3E%3Cstop offset='1' stop-color='%231e8ceb' /%3E%3C/radialGradient%3E%3CradialGradient id='s-j' cx='109.3' cy='13.8' r='93.1' gradientTransform='matrix(-.02 1.1 -1.04 -.02 137 -115)' xlink:href='%23s-b'%3E%3Cstop offset='0' stop-opacity='0' /%3E%3Cstop offset='1' stop-color='%235488d6' stop-opacity='0' /%3E%3Cstop offset='1' stop-color='%235d96eb' /%3E%3C/radialGradient%3E%3C/defs%3E%3Crect width='220' height='220' x='22' y='-107' fill='url(%23s-a)' ry='49' transform='matrix(.57 0 0 .57 187 256)' /%3E%3Cg transform='translate(194 190)'%3E%3Ccircle cx='67.8' cy='67.7' fill='url(%23s-c)' paint-order='stroke fill markers' r='54' /%3E%3Ccircle cx='-69.9' cy='69.3' fill='url(%23s-i)' transform='translate(138 -2)' r='54' /%3E%3C/g%3E%3Cellipse cx='120' cy='14.2' fill='url(%23s-j)' rx='93.1' ry='93.7' transform='matrix(.58 0 0 .58 192 250)' /%3E%3Cg transform='matrix(.58 0 0 .57 197 182)'%3E%3Cpath fill='%23cac7c8' d='M46 192h1l72-48-7-9-66 57Z' /%3E%3Cpath fill='%23fbfffc' d='M46 191v1l66-57-7-9-59 65Z' /%3E%3Cpath fill='url(%23s-d)' d='m119 144-7-9 66-57-59 66Z' /%3E%3Cpath fill='%23fb645c' d='m105 126 7 9 66-57-1-1-72 49Z' /%3E%3C/g%3E%3Cpath stroke='%23fff' stroke-linecap='round' stroke-miterlimit='1' stroke-width='1.3' d='m287 278 3-2m-12-17 8-2m-8-3h4m-4-13 8 2m-8 3h4m-1-13 7 3m-4-11 7 4m-2-11 6 6m0-12 6 7m1-11 4 6m4-10 3 7m5-9 2 7m15-7-1 7m10-5-3 7m11-4-4 7m11-2-5 6m16 7-7 4m10 4-7 3m10 6-8 1m8 16-8-2m5 10-7-3m4 11-7-4m2 11-6-5m0 11-5-6m-2 11-4-7m-4 11-3-8m-6 10-1-8m-16 8 2-8m-10 5 3-7m-11 4 4-7m-11 2 5-6m-8 3 3-3m4 8 2-3m5 8 2-4m6 7 1-4m8 5v-4m8 4v-4m9 3-1-4m9 1-2-4m9 0-2-4m9-2-3-3m8-4-3-2m8-5-4-2m7-6-4-1m5-8h-4m4-8h-4m3-9-4 1m1-9-4 2m-1-9-3 2m-2-9-3 3m-4-8-2 3m-5-8-2 4m-6-6-1 3m-8-5v4m-8-4v4m-9-2 1 3m-9 0 2 3m-9 1 2 3m-9 2 3 3m-8 4 3 2m-8 5 4 2m-7 6 4 1m-4 25 4-1m-2 5 7-3m-6 7 4-2m-2 6 7-4m-13-21h8m41-41v-8m0 99v-8m49-42h-8' transform='translate(-65 8)' /%3E%3C/svg%3E)

צוות Chrome החזיר את הרינדור המלא מראש של דפים עתידיים שסביר להניח שהמשתמשים יעברו אליהם.
היסטוריה קצרה של רינדור מראש
בעבר, Chrome תמך בהנחיית המשאבים <link rel="prerender" href="/next-page">, אבל היא לא נתמכה באופן נרחב מעבר ל-Chrome, והיא לא הייתה API מאוד אקספרסיבי.
הרינדור מראש הקודם באמצעות הרמז rel=prerender של הקישור הוצא משימוש לטובת NoState Prefetch, ששולף מראש את המשאבים שנדרשים לדף העתידי, אבל לא מרנדר מראש את הדף באופן מלא ולא מריץ JavaScript. אחזור מראש ללא מצב עוזר לשפר את ביצועי הדף על ידי שיפור טעינת המשאבים, אבל הוא לא יספק טעינת דף מיידית כמו עיבוד מראש מלא.
צוות Chrome החזיר את הרינדור המלא מראש ל-Chrome. כדי למנוע סיבוכים בשימוש הקיים ולאפשר הרחבה של הרינדור מראש בעתיד, מנגנון הרינדור מראש החדש לא ישתמש בתחביר <link rel="prerender"...>, שיישאר במקום בשביל NoState Prefetch, במטרה להוציא אותו משימוש בשלב כלשהו בעתיד.
איך דף עובר רינדור מראש?
אפשר לרנדר דף מראש באחת מ-4 דרכים, שכולן נועדו לזרז את הניווט:
- כשאתם מקלידים כתובת URL בסרגל הכתובות של Chrome (שנקרא גם "סרגל הכתובות המשולב"), יכול להיות ש-Chrome יבצע רינדור מראש של הדף באופן אוטומטי, אם יש סבירות גבוהה שתבקרו בדף הזה, על סמך היסטוריית הגלישה הקודמת שלכם.
- כשאתם משתמשים בסרגל הסימניות, Chrome עשוי לרנדר מראש את הדף באופן אוטומטי כשאתם מציבים את הסמן מעל אחד מכפתורי הסימניות.
- כשאתם מקלידים מונח חיפוש בסרגל הכתובות של Chrome, יכול להיות ש-Chrome יבצע רינדור מראש של דף תוצאות החיפוש באופן אוטומטי, אם מנוע החיפוש יורה לו לעשות זאת.
- אתרים יכולים להשתמש ב-Speculation Rules API כדי להורות ל-Chrome באופן פרוגרמטי אילו דפים לרנדר מראש. התכונה הזו מחליפה את מה ש-
<link rel="prerender"...>עשה בעבר, ומאפשרת לאתרים לעבד מראש דף באופן יזום על סמך כללי ספקולציות בדף. התגים האלה יכולים להיות סטטיים בדפים, או שבעל הדף יכול להוסיף אותם באופן דינמי באמצעות JavaScript.
בכל אחד מהמקרים האלה, הרינדור מראש פועל כאילו הדף נפתח בכרטיסייה בלתי נראית ברקע, ואז "מופעל" על ידי החלפת הכרטיסייה בחזית בדף שעבר רינדור מראש. אם דף מופעל לפני שהרינדור מראש שלו הושלם, המצב הנוכחי שלו הוא "בחזית" והוא ממשיך להיטען, כך שעדיין אפשר ליהנות מיתרון משמעותי.
הדף שעבר רינדור מראש נפתח במצב מוסתר, ולכן מספר ממשקי API שגורמים להתנהגויות פולשניות (לדוגמה, בקשות) לא מופעלים במצב הזה, אלא מושהים עד שהדף מופעל. במקרים המעטים שבהם זה עדיין לא אפשרי, העיבוד מראש מבוטל. צוות Chrome פועל כדי לחשוף את הסיבות לביטול הרינדור מראש כ-API, וגם לשפר את היכולות של כלי הפיתוח כדי שיהיה קל יותר לזהות מקרי קצה כאלה.
ההשפעה של רינדור מראש
רינדור מראש מאפשר טעינת דף כמעט מיידית, כמו שמוצג בסרטון הבא:
האתר לדוגמה כבר מהיר, אבל גם כאן אפשר לראות איך הרינדור מראש משפר את חוויית המשתמש. לכן, יכולה להיות לכך גם השפעה ישירה על Core Web Vitals של האתר, עם LCP קרוב לאפס, CLS מופחת (כי כל CLS של טעינה מתרחש לפני התצוגה הראשונית) ו-INP משופר (כי הטעינה אמורה להסתיים לפני שהמשתמש יוצר אינטראקציה).
גם אם הדף מופעל לפני שהוא נטען במלואו, היתרון של טעינת הדף מראש אמור לשפר את חוויית הטעינה. אם מפעילים קישור בזמן שהרינדור מראש עדיין מתבצע, הדף שעובר רינדור מראש יעבור למסגרת הראשית וימשיך להיטען.
עם זאת, רינדור מראש צורך יותר זיכרון ורוחב פס ברשת. חשוב להיזהר לא להגזים ברינדור מראש, כי זה עלול לבזבז משאבים של המשתמשים. כדאי לבצע רינדור מראש רק אם יש סבירות גבוהה שהמשתמשים ינווטו לדף.
בקטע מדידת ביצועים מוסבר איך למדוד את ההשפעה בפועל על הביצועים בניתוח הנתונים.
הצגת החיזויים של סרגל הכתובות ב-Chrome
בתרחיש הראשון, אפשר לראות את התחזיות של Chrome לגבי כתובות URL בדף chrome://predictors:
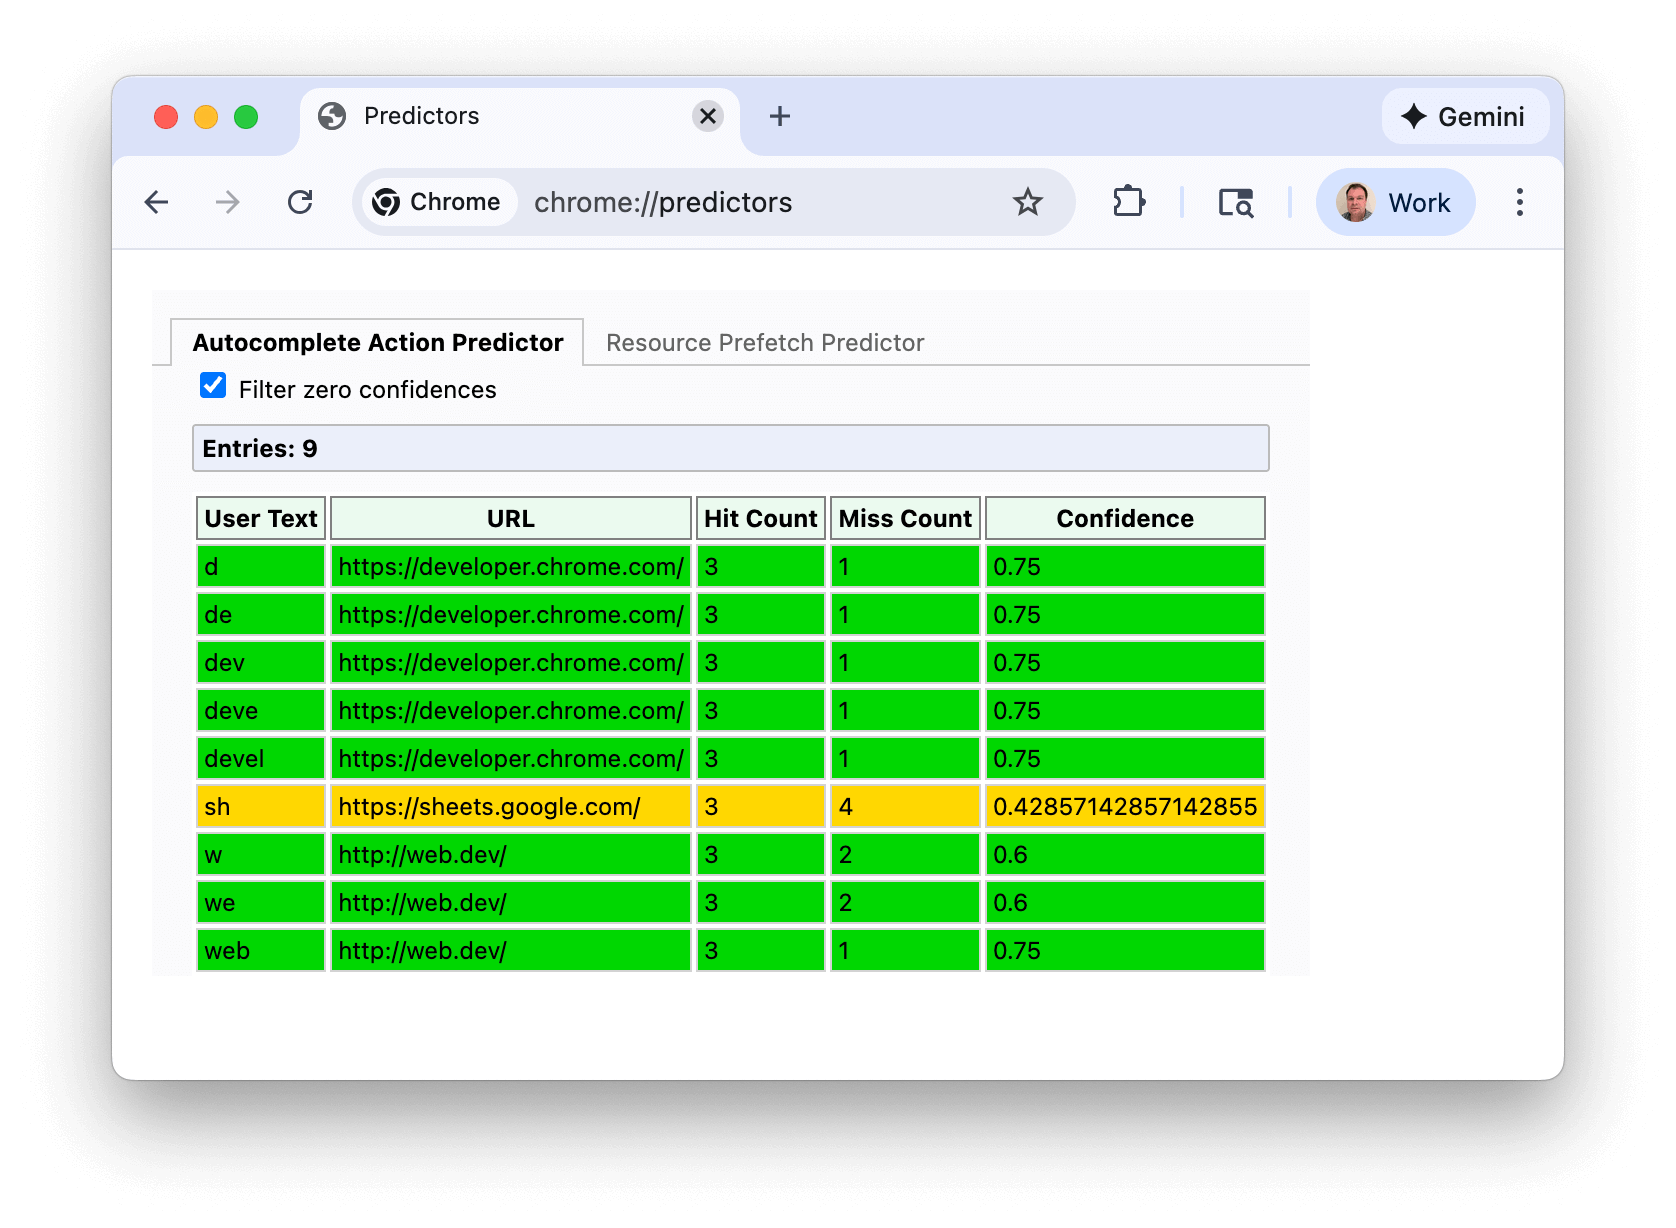
הקווים הירוקים מציינים שיש מספיק ודאות כדי להפעיל רינדור מראש. בדוגמה הזו, הקלדת האות "s" נותנת רמת סבירות סבירה (צהוב), אבל אחרי שמקלידים "sh", ל-Chrome יש מספיק סבירות שכמעט תמיד אתם מנווטים אל https://sheets.google.com.
צילום המסך הזה נלקח מהתקנה חדשה יחסית של Chrome, והוא מסנן תחזיות עם רמת סמך אפס. אבל אם תציגו את החזאים שלכם, סביר להניח שתראו הרבה יותר רשומות, ואולי תצטרכו יותר תווים כדי להגיע לרמת סמך גבוהה מספיק.
התחזיות האלה גם מפעילות את האפשרויות המוצעות בסרגל הכתובות שאולי שמתם לב אליהן:

Chrome יעדכן כל הזמן את החיזויים שלו על סמך ההקלדה והבחירות שלכם.
- אם רמת הסבירות גבוהה מ-30% (מוצגת בצבע ענבר), Chrome מתחבר מראש לדומיין באופן יזום, אבל לא מרנדר מראש את הדף.
- אם רמת הסמך גבוהה מ-50% (מוצגת בירוק), Chrome יבצע רינדור מראש של כתובת ה-URL.
Speculation Rules API
כדי להשתמש באפשרות הרינדור מראש של Speculation Rules API, מפתחי אתרים יכולים להוסיף הוראות JSON לדפים שלהם כדי להודיע לדפדפן אילו כתובות URL לרנדר מראש.
רשימת כתובות URL
כללי ספקולציות יכולים להתבסס על רשימות של כתובות URL:
<script type="speculationrules">
{
  "prerender": [{
    "urls": ["next.html", "next2.html"]
  }]
}
</script>
כללים למסמכים
כללי ספקולציות יכולים להיות גם "כללי מסמכים" באמצעות התחביר where. התכונה הזו מנחשת קישורים שנמצאים במסמך על סמך סלקטורים של href (על סמך API של תבנית URL) או סלקטורים ב-CSS:
<script type="speculationrules">
{
  "prerender": [{
    "where": {
      "and": [
        { "href_matches": "/*" },
        { "not": {"href_matches": "/wp-admin"}},
        { "not": {"href_matches": "/*\\?*(^|&)add-to-cart=*"}},
        { "not": {"selector_matches": ".do-not-prerender"}},
        { "not": {"selector_matches": "[rel~=nofollow]"}}
      ]
    }
  }]
}
</script>
התלהבות
ההגדרה eagerness משמשת כדי לציין מתי ההשערות אמורות לפעול, וזה שימושי במיוחד לכללי מסמכים:
-
conservative: ההשערה הזו מבוססת על לחיצה על הסמן או על המסך. moderate: במחשב, הפעולה הזו מבצעת ספקולציות אם מחזיקים את המצביע מעל קישור למשך 200 אלפיות השנייה (או באירועpointerdownאם הוא מתרחש מוקדם יותר, ובנייד שבו אין אירועhover). בניידים, החל מאוגוסט 2025, שינינו את השיטה הזו והיא מבוססת על היוריסטיקה מורכבת של אזור התצוגה. היוריסטיקות מורכבות של אזור התצוגה מופעלות 500 אלפיות השנייה אחרי שהמשתמש הפסיק לגלול, עבור עוגנים בטווח של 30% מהמרחק האנכי מהלחיצה הקודמת, כאשר העוגנים גדולים פי 0.5 לפחות מהעוגן הגדול ביותר באזור התצוגה. כמו שמתואר במסמך הזה.-
eager: רמת הלהיטות הזו הייתה זהה ל-immediate, אבל השתנתה החל מגרסה 143 של Chrome. במחשב, הפעולה הזו מבצעת ספקולציות אם מחזיקים את המצביע מעל קישור למשך 10 אלפיות השנייה. בנייד, החל מינואר 2026, אנחנו מתבססים על היוריסטיקה פשוטה של אזור התצוגה. היוריסטיקות פשוטות של אזור התצוגה מופעלות 50 אלפיות השנייה אחרי שהעוגן נכנס לאזור התצוגה. immediate: האפשרות הזו משמשת לביצוע ספקולציה בהקדם האפשרי, כלומר ברגע שכללי הספקולציות נצפים.
ברירת המחדל של eagerness לכללי list היא immediate. אפשר להשתמש באפשרויות eager, moderate ו-conservative כדי להגביל את כללי list לכתובות URL שהמשתמש יוצר איתן אינטראקציה לרשימה ספציפית. עם זאת, במקרים רבים, כללי document עם תנאי where מתאים עשויים להיות מתאימים יותר.
ברירת המחדל של eagerness לכללי document היא conservative. מסמך יכול להכיל הרבה כתובות URL, ולכן צריך להשתמש בזהירות ב-immediate לכללי document (ראו גם את הקטע מגבלות ב-Chrome בהמשך).
ההגדרה של eagerness שבה צריך להשתמש תלויה באתר שלכם. באתר סטטי וקל, יכול להיות ששליפה מראש אגרסיבית יותר תהיה זולה ותועיל למשתמשים. באתרים עם ארכיטקטורה מורכבת יותר ודפים כבדים יותר, יכול להיות שעדיף להפחית את הבזבוז על ידי הפחתת תדירות ההשערות עד שתקבלו אות חיובי יותר לגבי כוונת המשתמשים, כדי להגביל את הבזבוז.
האפשרות moderate היא פשרה, והרבה אתרים יכולים להפיק תועלת מכלל הספקולציה הבא, שירנדר מראש קישור כשמחזיקים את הסמן מעל הקישור למשך 200 אלפיות השנייה או באירוע pointerdown, כהטמעה בסיסית אבל יעילה של כללי ספקולציה:
<script type="speculationrules">
{
  "prerender": [{
    "where": {
      "href_matches": "/*"
    },
    "eagerness": "moderate"
  }]
}
</script>
שליפה מראש (prefetch)
אפשר להשתמש בכללי ספקולציות גם כדי לבצע רק שליפה מראש (prefetch) של דפים, בלי עיבוד מראש מלא. לרוב, זה יכול להיות שלב ראשון טוב בדרך לרינדור מראש:
<script type="speculationrules">
{
  "prefetch": [{
    "urls": ["next.html", "next2.html"]
  }]
}
</script>
Prerender until script
הצוות של Chrome פועל גם כדי להוסיף את prerender_until_script ל-Speculation Rules API (ראו: באג בהטמעה). זה יהיה שלב בין שליפה מראש לרינדור מראש, והוא ישמש באופן דומה:
<script type="speculationrules">
{
  "prerender_until_script": [{
    "urls": ["next.html", "next2.html"]
  }]
}
</script>
בדומה ל-NoState prefetch, הפעולה הזו תאחזר מראש גם את מסמך ה-HTML וגם את משאבי המשנה שזמינים ב-HTML הזה. עם זאת, הוא ימשיך מעבר לכך וגם יתחיל לרנדר מראש את הדף, ויפסיק כשהוא ייתקל בסקריפט הראשון.
זה אומר שבדפים שאין בהם JavaScript, או שיש בהם JavaScript רק בכותרת התחתונה, אפשר לרנדר מראש כמעט את כל הדף. דפים עם סקריפטים ב-<head> לא יוכלו לעבור רינדור מראש, אבל עדיין ייהנו מאחזור משאבי המשנה.
כך אפשר להימנע מהסיכונים של תופעות לוואי לא מכוונות מהפעלת JavaScript, אבל לאפשר שיפור ביצועים גדול בהרבה מאשר רק prefetch.
מגבלות ב-Chrome
ב-Chrome יש מגבלות שנועדו למנוע שימוש יתר ב-Speculation Rules API:
| התלהבות | שליפה מראש (prefetch) | רינדור מראש |
|---|---|---|
immediate |
50 | 10 |
eager מתוך moderate בנייד |
6 (FIFO) | 2 (FIFO) |
eager / moderate במחשב |
2 (FIFO) | 2 (FIFO) |
conservative |
2 (FIFO) | 2 (FIFO) |
ההגדרות eager, moderate ו-conservative, שתלויות באינטראקציה של המשתמש, פועלות בשיטת נכנס ראשון יוצא ראשון (FIFO): אחרי שמגיעים למגבלה, ספקולציה חדשה תגרום לביטול הספקולציה הישנה ביותר ולהחלפה שלה בספקולציה החדשה יותר כדי לחסוך בזיכרון.
אפשר להפעיל שוב ספקולציה שבוטלה – לדוגמה, על ידי הצבת הסמן מעל הקישור הזה שוב – מה שיגרום לספקולציה מחדש של כתובת ה-URL הזו, ולהוצאת הספקולציה הישנה ביותר. במקרה כזה, השליפה המקדימה הקודמת תשמור במטמון את כל המשאבים שניתן לשמור במטמון ב-HTTP Cache של כתובת ה-URL הזו, כך ששליפה מקדימה נוספת תהיה בעלות מופחתת. לכן, כברירת מחדל, המגבלה מוגדרת לסף הנמוך של 2. אנחנו משתמשים בסף גבוה יותר של 6 לאחזור מראש בנייד כי אין "ריחוף", ההיוריסטיקה החלופית של אזור התצוגה בנייד פחות מדויקת, ואחזור מראש פחות יקר מעיבוד מראש (אנחנו שומרים על מגבלה של 2 לעיבוד מראש בנייד).
כללים של רשימות סטטיות לא מופעלים על ידי פעולת משתמש, ולכן יש להם מגבלה גבוהה יותר, כי הדפדפן לא יכול לדעת אילו כללים נדרשים ומתי הם נדרשים.
בנוסף, ב-Chrome שוקלים להגדיל את המגבלה ל-5 בניידים עבור eager ו-moderate, לפחות לשליפה מראש (prefetch), כי זו שיטה היוריסטית פחות מדויקת. מפתחים שמשתמשים ב-eager יכולים לשקול להשתמש גם בכללים של conservative במקרים שבהם יש כמה קישורים זמינים באזור התצוגה, כדי שהם עדיין יטענו מראש גם אם הם לא נבחרו כאחד משני הקישורים הראשונים.
המגבלה של immediate היא גם דינמית, כך שהסרה של רכיב סקריפט של כתובת URL מסוג list תפנה מקום על ידי ביטול ההשערות שהוסרו.
בנוסף, Chrome ימנע שימוש בהשערות בתנאים מסוימים, כולל:
- Save-Data.
- מצב חיסכון באנרגיה כשהוא מופעל ורמת הטעינה של הסוללה נמוכה.
- מגבלות זיכרון.
- כשההגדרה "טעינה מראש של דפים" מושבתת (היא מושבתת באופן מפורש גם על ידי תוספים ל-Chrome כמו uBlock Origin).
- דפים שנפתחו בכרטיסיות ברקע.
בנוסף, Chrome לא מעבד iframe ממקורות שונים בדפים שעברו עיבוד מראש עד להפעלה.
כל התנאים האלה נועדו לצמצם את ההשפעה של ספקולציות מוגזמות, במקרים שבהם הן עלולות להזיק למשתמשים.
איך כוללים כללי ספקולציות בדף
אפשר לכלול כללי ספקולציה באופן סטטי ב-HTML של הדף, או להוסיף אותם באופן דינמי לדף באמצעות JavaScript:
- כללי ספקולציה שכלולים באופן סטטי: לדוגמה, אתר חדשות או בלוג יכולים לרנדר מראש את המאמר החדש ביותר, אם זה בדרך כלל המעבר הבא של חלק גדול מהמשתמשים. לחלופין, אפשר להשתמש בכללי מסמכים עם
moderateאוconservativeכדי לבצע ספקולציה כשהמשתמשים יוצרים אינטראקציה עם קישורים. - כללי ספקולציה שנוספו באופן דינמי: הכללים האלה יכולים להתבסס על הלוגיקה של האפליקציה, להיות מותאמים אישית למשתמש או להתבסס על שיטות היוריסטיות אחרות.
אם אתם מעדיפים הוספה דינמית על סמך פעולות כמו העברת העכבר מעל קישור או לחיצה עליו – כמו שספריות רבות עשו בעבר באמצעות <link rel=prefetch> – מומלץ לעיין בכללי המסמך, כי הם מאפשרים לדפדפן לטפל בהרבה מהתרחישים לדוגמה שלכם.
אפשר להוסיף כללי ספקולציה ב-<head> או ב-<body> של המסגרת הראשית. כללי ספקולציות במסגרות משנה לא מופעלים, וכללי ספקולציות בדפים שעברו רינדור מראש מופעלים רק אחרי שהדף מופעל.
כותרת ה-HTTP של Speculation-Rules
אפשר גם להעביר כללי ספקולציה באמצעות כותרת HTTP מסוג Speculation-Rules, במקום לכלול אותם ישירות ב-HTML של המסמך. כך רשתות CDN יכולות לפרוס את התוכן בקלות רבה יותר, בלי לשנות את תוכן המסמכים עצמם.
כותרת ה-HTTP Speculation-Rules מוחזרת עם המסמך, ומצביעה על מיקום של קובץ JSON שמכיל את כללי ההשערה:
Speculation-Rules: "/speculationrules.json"
המשאב הזה צריך להשתמש בסוג ה-MIME הנכון, ואם הוא משאב ממקורות שונים, הוא צריך לעבור בדיקת CORS.
Content-Type: application/speculationrules+json
Access-Control-Allow-Origin: *
אם אתם רוצים להשתמש בכתובות URL יחסיות, כדאי לכלול את המפתח "relative_to": "document" בכללי ההשערה. אחרת, כתובות URL יחסיות יהיו יחסיות לכתובת ה-URL של קובץ ה-JSON של כללי הספקולציה. האפשרות הזו שימושית במיוחד אם אתם צריכים לבחור חלק מהקישורים מאותו מקור, או את כולם.
שדה התג של כללי הספקולציות
אפשר גם להוסיף "תגים" בתחביר ה-JSON של כללי הספקולציה ברמה הכללית לכל כללי הספקולציה בקבוצת כללים:
{
  "tag": "my-rules",
  "prefetch": [{
      "urls": ["next.html"]
  }],
  "prerender": [{
      "urls": ["next2.html"]
  }]
}
או ברמת הכלל הספציפי:
{
  "prefetch": [{
    "tag": "my-prefetch-rules",
    "urls": ["next.html"]
  }],
  "prerender": [{
    "tag": "my-prerender-rules",
    "urls": ["next2.html"]
  }]
}
התג הזה משתקף בכותרת ה-HTTP של Sec-Speculation-Tags, ואפשר להשתמש בו כדי לסנן כללי ספקולציה בשרת. כותרת ה-HTTP Sec-Speculation-Tags יכולה לכלול כמה תגים אם ההשערה מכוסה על ידי כמה כללים, כמו בדוגמה הבאה:
Sec-Speculation-Tags: null
Sec-Speculation-Tags: null, "cdn-prefetch"
Sec-Speculation-Tags: "my-prefetch-rules"
Sec-Speculation-Tags: "my-prefetch-rules", "my-rules", "cdn-prefetch"
חלק מרשתות ה-CDN מוסיפות באופן אוטומטי כללי ספקולציה, אבל חוסמות ספקולציות לדפים שלא נשמרו במטמון קצה כדי למנוע מצב שבו התכונה הזו תגרום לשימוש מוגבר בשרת המקור. התגים מאפשרים להם לזהות את ההנחות שהתחילו על ידי קבוצת הכללים שמוגדרת כברירת מחדל, אבל עדיין מאפשרים לכללים שנוספו על ידי האתר לעבור למקור.
תגי קבוצת הכללים מוצגים גם בכלי הפיתוח ל-Chrome.
שדה target_hint של כללי ספקולציות
כללי הספקולציה יכולים לכלול גם שדה target_hint, שמכיל מילת מפתח או שם חוקי של הקשר גלישה שמציינים איפה הדף מצפה שהתוכן שרונדר מראש יופעל:
<script type=speculationrules>
{
  "prerender": [{
    "target_hint": "_blank",
    "urls": ["next.html"]
  }]
}
</script>
ההנחיה הזו מאפשרת לטפל בהשערות לגבי רינדור מראש של קישורים ב-target="_blank":
<a target="_blank" href="next.html">Open this link in a new tab</a>
נכון לעכשיו, רק "target_hint": "_blank" ו-"target_hint": "_self" (ברירת המחדל אם לא צוין אחרת) נתמכים ב-Chrome ורק לרינדור מראש – אין תמיכה באחזור מראש.
השדה target_hint נדרש רק לכללי ספקולציה מסוג urls, כי בכללי מסמכים, השדה target ידוע מהקישור עצמו.
כללי ספקולציות ו-SPA
כללי הספקולציה נתמכים רק בניווט בדפים מלאים שמנוהלים על ידי הדפדפן, ולא באפליקציות של דף יחיד (SPA) או בדפים של מעטפת אפליקציה. בארכיטקטורות האלה לא מתבצעות אחזורי מסמכים, אלא אחזורים חלקיים של נתונים או דפים באמצעות API – ולאחר מכן הם מעובדים ומוצגים בדף הנוכחי. האפליקציה יכולה לאחזר מראש את הנתונים שנדרשים ל "ניווטים הדינמיים" האלה, אבל הם לא יכולים לעבור רינדור מראש.
אפשר להשתמש בכללי ספקולציות כדי לרנדר מראש את האפליקציה עצמה מדף קודם. כך אפשר לקזז חלק מהעלויות הנוספות של הטעינה הראשונית שקיימות בחלק מה-SPA. עם זאת, אי אפשר לרנדר מראש שינויים בנתיב בתוך האפליקציה.
ניפוי באגים בכללי הטעינה מראש
בפוסט הייעודי בנושא ניפוי באגים בכללי ספקולציה מפורטות תכונות חדשות של כלי הפיתוח ל-Chrome, שעוזרות להציג את ה-API החדש הזה ולנפות בו באגים.
מספר כללים של טעינות מראש
אפשר גם להוסיף כמה כללי ספקולציה לאותו דף, והם יתווספו לכללים הקיימים. לכן, הדרכים השונות הבאות מובילות לרינדור מראש של one.html וגם של two.html:
רשימת כתובות URL:
<script type="speculationrules">
{
  "prerender": [{
    "urls": ["one.html", "two.html"]
  }]
}
</script>
כמה סקריפטים של speculationrules:
<script type="speculationrules">
{
  "prerender": [{
    "urls": ["one.html"]
  }]
}
</script>
<script type="speculationrules">
{
  "prerender": [{
    "urls": ["two.html"]
  }]
}
</script>
כמה רשימות בתוך קבוצה אחת של speculationrules
<script type="speculationrules">
{
  "prerender": [
    {
      "urls": ["one.html"]
    },
    {
      "urls": ["two.html"]
    }
  ]
}
</script>
התמיכה של No-Vary-Search
כשמאחזרים מראש או מרנדרים מראש דף, יכול להיות שפרמטרים מסוימים של כתובות URL (שמבחינה טכנית נקראים פרמטרים של חיפוש) לא יהיו חשובים לדף שהשרת מספק בפועל, ורק JavaScript בצד הלקוח ישתמש בהם.
לדוגמה, מערכת Google Analytics משתמשת בפרמטרים של מנטר התנועה של Urchin (UTM) למדידת קמפיינים, אבל בדרך כלל הם לא גורמים להצגת דפים שונים מהשרת. כלומר, page1.html?utm_content=123 ו-page1.html?utm_content=456 יציגו את אותו דף מהשרת, כך שאפשר יהיה להשתמש שוב באותו דף מהמטמון.
באופן דומה, אפליקציות יכולות להשתמש בפרמטרים אחרים של כתובות URL שמטופלים רק בצד הלקוח.
ההצעה No-Vary-Search מאפשרת לשרת לציין פרמטרים שלא גורמים להבדל במשאב שנמסר, ולכן מאפשרת לדפדפן לעשות שימוש חוזר בגרסאות של מסמך שנשמרו בעבר במטמון, שההבדל היחיד ביניהן הוא הפרמטרים האלה. התכונה הזו נתמכת ב-Chrome (ובדפדפנים שמבוססים על Chromium) להשערות ניווט גם לאחזור מראש וגם לעיבוד מראש.
כללי הספקולציה תומכים בשימוש ב-expects_no_vary_search כדי לציין איפה צפויה לחזור כותרת HTTP מסוג No-Vary-Search. כך אפשר להימנע מהורדות מיותרות לפני שרואים את התשובות.
<script type="speculationrules">
{
  "prefetch": [{
    "urls": ["/products"],
    "expects_no_vary_search": "params=(\"id\")"
  }]
}
</script>

<a href="/products?id=123">Product 123</a>
<a href="/products?id=124">Product 124</a>
בדוגמה הזו, ה-HTML הראשוני של הדף /products זהה למזהי המוצרים 123 ו-124. עם זאת, תוכן הדף משתנה בסופו של דבר על סמך עיבוד בצד הלקוח באמצעות JavaScript כדי לאחזר את נתוני המוצר באמצעות פרמטר החיפוש id. לכן אנחנו מאחזרים מראש את כתובת ה-URL הזו, והיא אמורה להחזיר כותרת HTTP מסוג No-Vary-Search שמראה שאפשר להשתמש בדף לכל פרמטר חיפוש מסוג id.
עם זאת, אם המשתמש לוחץ על אחד מהקישורים לפני שהשליפה מראש הושלמה, יכול להיות שהדף /products לא התקבל בדפדפן. במקרה כזה, הדפדפן לא יודע אם הוא יכיל את כותרת ה-HTTP No-Vary-Search. בשלב הזה, הדפדפן יכול לבחור אם לאחזר את הקישור שוב, או להמתין עד שהאחזור מראש יסתיים כדי לבדוק אם הוא מכיל כותרת HTTP מסוג No-Vary-Search. ההגדרה expects_no_vary_search מאפשרת לדפדפן לדעת שתגובת הדף צפויה להכיל כותרת HTTP מסוג No-Vary-Search, ולהמתין עד להשלמת השליפה מראש.
אפשר גם להוסיף כמה פרמטרים ל-expects_no_vary_search עם רווח שמפריד ביניהם (כי No-Vary-Search היא כותרת HTTP מובנית):
"expects_no_vary_search": "params=(\"param1\" \"param2\" \"param3\")"
הגבלות על כללי ספקולציות ושיפורים עתידיים
כללי ההשערה מוגבלים לדפים שנפתחים באותה כרטיסייה, אבל אנחנו פועלים כדי לצמצם את ההגבלה הזו.
כברירת מחדל, הרינדור מראש מוגבל לדפים מאותו מקור. אפשר להפעיל עיבוד מראש של דפים ממקורות שונים באותו אתר (לדוגמה, https://a.example.com יכול לעבד מראש דף ב-https://b.example.com). כדי להשתמש בזה, הדף המשוער (https://b.example.com בדוגמה הזו) צריך להביע הסכמה על ידי הכללת כותרת HTTP מסוג Supports-Loading-Mode: credentialed-prerender, אחרת Chrome יבטל את ההשערה.
יכול להיות שבגרסאות עתידיות יתאפשר גם עיבוד מראש של דפים ממקורות שונים שלא שייכים לאותו אתר, כל עוד אין קובצי Cookie בדף שעבר עיבוד מראש, והדף שעבר עיבוד מראש מצטרף עם כותרת HTTP דומה של Supports-Loading-Mode: uncredentialed-prerender.
כללי הטעינה מראש כבר תומכים בשליפות מראש ממקורות שונים. אין הגבלות על שליפות מראש ממקורות שונים באותו אתר. אחזורים מראש ממקורות שונים באתרים שונים נתמכים רק כשאין קובצי Cookie לדומיין ממקורות שונים. אם יש קובצי Cookie מהביקור הקודם של המשתמש באתר, לא ייעשה שימוש בהשערה ויוצג כשל ב-DevTools.
בהתחשב במגבלות האלה, דפוס אחד שיכול לשפר את חוויית המשתמשים גם בקישורים פנימיים וגם בקישורים חיצוניים, כשאפשר, הוא לבצע עיבוד מראש של כתובות URL מאותו מקור ולנסות לבצע שליפה מראש של כתובות URL ממקורות שונים:
<script type="speculationrules">
  {
    "prerender": [{
      "where": { "href_matches": "/*" },
      "eagerness": "moderate"
    }],
    "prefetch": [{
      "where": { "not": { "href_matches": "/*" } },
      "eagerness": "moderate"
    }]
  }
</script>
ההגבלה שמונעת כברירת מחדל השערות ממקורות שונים לגבי קישורים ממקורות שונים נחוצה מטעמי אבטחה. זהו שיפור לעומת <link rel="prefetch"> ליעדים ממקורות שונים, שגם לא ישלחו קובצי Cookie אבל עדיין ינסו לבצע את השליפה מראש – מה שיגרום לשליפה מראש מבוזבזת שצריך לשלוח מחדש, או גרוע מכך, לטעינת הדף השגוי.
זיהוי תמיכה ב-Speculation Rules API
אתם יכולים לזהות תכונות שנתמכות ב-Speculation Rules API באמצעות בדיקות HTML רגילות:
if (HTMLScriptElement.supports && HTMLScriptElement.supports('speculationrules')) {
  console.log('Your browser supports the Speculation Rules API.');
}
הוספת כללי ספקולציות באופן דינמי באמצעות JavaScript
זו דוגמה להוספת כלל ספקולציה של prerender באמצעות JavaScript:
if (HTMLScriptElement.supports &&
    HTMLScriptElement.supports('speculationrules')) {
  const specScript = document.createElement('script');
  specScript.type = 'speculationrules';
  specRules = {
    prerender: [
      {
        urls: ['/next.html'],
      },
    ],
  };
  specScript.textContent = JSON.stringify(specRules);
  console.log('added speculation rules to: next.html');
  document.body.append(specScript);
}
בדף ההדגמה הזה של רינדור מראש אפשר לראות הדגמה של רינדור מראש באמצעות Speculation Rules API, באמצעות הוספת JavaScript.
הוספה של רכיב <script type = "speculationrules"> ישירות ל-DOM באמצעות innerHTML לא תרשום את כללי הספקולציה מטעמי אבטחה, וצריך להוסיף אותם כמו שמוצג למעלה. עם זאת, תוכן שנוסף באופן דינמי באמצעות innerHTML ומכיל קישורים חדשים, יזוהה על ידי הכללים הקיימים בדף.
באופן דומה, עריכה ישירה של החלונית Elements בכלי הפיתוח ל-Chrome כדי להוסיף את הרכיב <script type = "speculationrules"> לא רושמת את כללי ההשערה. במקום זאת, צריך להריץ מהמסוף את הסקריפט להוספה דינמית של הרכיב ל-DOM כדי להוסיף את הכללים.
הוספת כללי ספקולציה באמצעות Tag Manager
כדי להוסיף כללי ספקולציה באמצעות מנהל תגים כמו Google Tag Manager (GTM), צריך להוסיף אותם דרך JavaScript, במקום להוסיף את הרכיב <script type = "speculationrules"> דרך GTM ישירות, מאותן סיבות שצוינו קודם:

שימו לב שבדוגמה הזו נעשה שימוש ב-var כי GTM לא תומך ב-const.
ביטול כללי הטעינות מראש
הסרת כללי הספקולציות תגרום לביטול הרינדור מראש. עם זאת, עד שזה יקרה, סביר להניח שכבר יושקעו משאבים כדי להתחיל את הרינדור מראש, ולכן מומלץ לא לבצע רינדור מראש אם יש סיכוי שיהיה צורך לבטל אותו. מצד שני, עדיין אפשר לעשות שימוש חוזר במשאבים שנשמרו במטמון, כך שהביטולים לא בהכרח מבוזבזים לחלוטין ויכולים להועיל לפעולות ספקולטיביות ולניווטים בעתיד.
אפשר גם לבטל את הטעינה מראש באמצעות כותרת ה-HTTP Clear-Site-Data עם ההוראות prefetchCache ו-prerenderCache.
האפשרות הזו יכולה להיות שימושית כשהמצב משתנה בשרת. לדוגמה, כששולחים קריאה ל-API של "הוספה לעגלת הקניות" או ל-API של התחברות או התנתקות.
באופן אידיאלי, עדכוני המצב האלה יופצו לדפים שעברו עיבוד מראש באמצעות ממשקי API כמו Broadcast Channel API, אבל אם זה לא אפשרי, או עד שהלוגיקה הזו תוטמע, יכול להיות שיהיה קל יותר לבטל את ההשערה.
כללי ספקולציה ו-Content Security Policy (מדיניות אבטחת תוכן)
כללי הספקולציה משתמשים ברכיב <script>, למרות שהם מכילים רק JSON, ולכן צריך לכלול אותם ב-script-src Content-Security-Policy אם האתר משתמש בזה – באמצעות גיבוב (hash) או מספר חד-פעמי (nonce).
אפשר להוסיף inline-speculation-rules חדש אל script-src כדי לתמוך ברכיבי <script type="speculationrules"> שנוספו מסקריפטים עם גיבוב (hash) או עם מספר חד-פעמי (nonce). האפשרות הזו לא תומכת בכללים שכלולים ב-HTML הראשוני, ולכן צריך להחדיר את הכללים באמצעות JavaScript לאתרים שמשתמשים ב-CSP מחמיר.
זיהוי והשבתה של רינדור מראש
רינדור מראש בדרך כלל משפר את חוויית המשתמש כי הוא מאפשר רינדור מהיר של הדף – לעיתים קרובות באופן מיידי. התהליך הזה מועיל גם למשתמש וגם לבעלי האתר, כי דפים שרונדרו מראש מספקים חוויית משתמש טובה יותר, שקשה להשיג בדרך אחרת.
עם זאת, יכולים להיות מקרים שבהם לא תרצו שיתבצע רינדור מראש של דפים, למשל כשהמצב של הדפים משתנה – על סמך הבקשה הראשונית או על סמך JavaScript שפועל בדף.
הפעלה והשבתה של רינדור מראש ב-Chrome
הרינדור מראש מופעל רק למשתמשי Chrome שהפעילו את ההגדרה "טעינה מראש של דפים" ב-chrome://settings/performance/. בנוסף, הרינדור מראש מושבת גם במכשירים עם זיכרון מועט, או אם מערכת ההפעלה נמצאת במצב "חוסך נתונים" או "חיסכון באנרגיה". עיינו בקטע המגבלות של Chrome.
זיהוי והשבתה של רינדור מראש בצד השרת
דפים שעברו רינדור מראש יישלחו עם כותרת ה-HTTP הבאה: Sec-Purpose:
Sec-Purpose: prefetch;prerender
בדפים שנשלפו מראש באמצעות Speculation Rules API, הכותרת הזו תוגדר רק כ-prefetch:
Sec-Purpose: prefetch
השרתים יכולים להגיב על סמך הכותרת הזו, כדי לתעד בקשות ספקולטיביות, להחזיר תוכן שונה או למנוע רינדור מראש. אם מוחזר קוד תגובה סופי שלא מציין הצלחה – כלומר, לא בטווח 200-299 אחרי הפניות אוטומטיות – הדף לא יעבור רינדור מראש וכל דף שאוחזר מראש יימחק. חשוב גם לדעת שתגובות 204 ו-205 לא תקפות לרינדור מראש, אבל הן תקפות לשליפה מראש.
אם אתם לא רוצים שדף מסוים יעבור רינדור מראש, הדרך הכי טובה לוודא שזה לא יקרה היא להחזיר קוד תגובה שהוא לא 2XX (למשל 503). עם זאת, כדי לספק את חוויית השימוש הטובה ביותר, מומלץ לאפשר רינדור מראש, אבל לעכב פעולות שצריכות להתבצע רק כשהדף נצפה בפועל, באמצעות JavaScript.
זיהוי רינדור מראש ב-JavaScript
ה-API של document.prerendering יחזיר את הערך true בזמן שהדף עובר רינדור מראש. דפים יכולים להשתמש בזה כדי למנוע או לעכב פעילויות מסוימות במהלך הרינדור מראש, עד שהדף מופעל בפועל.
אחרי שמסמך שעבר עיבוד מראש מופעל, גם הערך של activationStart ב-PerformanceNavigationTiming יוגדר לזמן שאינו אפס, שמייצג את הזמן שחלף בין תחילת העיבוד מראש לבין הפעלת המסמך בפועל.
אתם יכולים להשתמש בפונקציה כדי לבדוק אם יש דפים שעוברים רינדור מראש או עברו רינדור מראש, כמו בדוגמה הבאה:
function pagePrerendered() {
  return (
    document.prerendering ||
    self.performance?.getEntriesByType?.('navigation')[0]?.activationStart > 0
  );
}
הדרך הכי קלה לבדוק אם דף רונדר מראש (באופן מלא או חלקי) היא לפתוח את כלי הפיתוח אחרי שהדף מופעל ולהקליד performance.getEntriesByType('navigation')[0].activationStart במסוף. אם מוחזר ערך שאינו אפס, סימן שהדף רונדר מראש:

כשהמשתמש מפעיל את הדף על ידי צפייה בו, האירוע prerenderingchange נשלח אל document. לאחר מכן אפשר להשתמש באירוע הזה כדי להפעיל פעילויות שבדרך כלל מתחילות כברירת מחדל בטעינת דף, אבל אתם רוצים לעכב אותן עד שהמשתמש באמת יצפה בדף.
באמצעות ממשקי ה-API האלה, JavaScript של ממשק הקצה יכול לזהות דפים שעברו רינדור מראש ולפעול בהתאם.
ההשפעה על ניתוח הנתונים
ניתוח נתונים משמש למדידת השימוש באתר, למשל באמצעות Google Analytics למדידת צפיות בדפים ואירועים. או על ידי מדידת מדדי הביצועים של הדפים באמצעות מעקב אחר משתמשים אמיתיים (RUM).
כדאי לרנדר מראש דפים רק אם יש סבירות גבוהה שהמשתמש יטען את הדף. לכן, אפשרויות הרינדור מראש של סרגל הכתובות ב-Chrome מתרחשות רק כשיש סבירות גבוהה (יותר מ-80% מהמקרים).
עם זאת, במיוחד כשמשתמשים ב-Speculation Rules API, דפים שעברו רינדור מראש עשויים להשפיע על ניתוח הנתונים, וייתכן שבעלי האתרים יצטרכו להוסיף קוד כדי להפעיל את ניתוח הנתונים רק בדפים שעברו רינדור מראש בזמן ההפעלה, כי לא כל ספקי ניתוח הנתונים עושים זאת כברירת מחדל.
כדי לעשות את זה, אפשר להשתמש ב-Promise שממתין לאירוע prerenderingchange אם מתבצע רינדור מראש של מסמך, או פותר את הבעיה מיד אם הוא מתבצע עכשיו:
// Set up a promise for when the page is activated,
// which is needed for prerendered pages.
const whenActivated = new Promise((resolve) => {
  if (document.prerendering) {
    document.addEventListener('prerenderingchange', resolve, {once: true});
  } else {
    resolve();
  }
});

async function initAnalytics() {
  await whenActivated;
  // Initialise your analytics
}

initAnalytics();
גישה חלופית היא לעכב את פעילויות הניתוח עד שהדף מוצג בפעם הראשונה. הגישה הזו תכסה גם את המקרה של רינדור מראש, וגם את המקרה שבו כרטיסיות נפתחות ברקע (לדוגמה, בלחיצה ימנית ופתיחה בכרטיסייה חדשה):
// Set up a promise for when the page is first made visible
const whenFirstVisible = new Promise((resolve) => {
  if (document.hidden) {
    document.addEventListener('visibilitychange', resolve, {once: true});
  } else {
    resolve();
  }
});

async function initAnalytics() {
  await whenFirstVisible;
  // Initialise your analytics
}

initAnalytics();
זה יכול להיות הגיוני לניתוח נתונים ולתרחישים דומים, אבל במקרים אחרים יכול להיות שתרצו לטעון יותר תוכן, ולכן כדאי להשתמש ב-document.prerendering וב-prerenderingchange כדי לטרגט באופן ספציפי דפים שנטענים מראש.
עיכוב תוכן אחר במהלך רינדור מראש
אפשר להשתמש באותם ממשקי API שצוינו קודם כדי לעכב תוכן אחר במהלך שלב הרינדור מראש. אלה יכולים להיות חלקים ספציפיים של JavaScript או רכיבי סקריפט שלמים שאתם מעדיפים לא להריץ במהלך שלב הרינדור מראש.
לדוגמה, נניח שזה הסקריפט:
<script src="https://example.com/app/script.js" async></script>
אפשר לשנות את זה לרכיב סקריפט שנוסף באופן דינמי, שמוסיף רק על סמך הפונקציה whenActivated הקודמת:
async function addScript(scriptUrl) {
  await whenActivated;
  const script = document.createElement('script');
  script.src = 'scriptUrl';
  document.body.appendChild(script);
}

addScript('https://example.com/app/script.js');
האפשרות הזו יכולה להיות שימושית כדי לעכב סקריפטים נפרדים שכוללים ניתוח נתונים, או כדי להציג תוכן על סמך מצב או משתנים אחרים שיכולים להשתנות במהלך הביקור. לדוגמה, יכול להיות שהמערכת תעכב את הטעינה של המלצות, סטטוס התחברות או סמלים של עגלות קניות כדי להציג את המידע הכי עדכני.
יכול להיות שזה יקרה לעיתים קרובות יותר כשמשתמשים ברינדור מראש, אבל התנאים האלה רלוונטיים גם לדפים שנטענים בכרטיסיות ברקע שהוזכרו קודם (כך שאפשר להשתמש בפונקציה whenFirstVisible במקום whenActivated).
במקרים רבים, כדאי לבדוק את המצב גם בשינויים כלליים ב-visibilitychange. לדוגמה, כשחוזרים לדף שהיה ברקע, כל המונים של עגלת הקניות צריכים להתעדכן במספר הפריטים העדכני בעגלה. לכן, לא מדובר בבעיה שספציפית לרינדור מראש, אלא שהרינדור מראש פשוט מבליט בעיה קיימת.
אחת הדרכים שבהן Chrome מפחית את הצורך לעטוף סקריפטים או פונקציות באופן ידני היא שממשקי API מסוימים נשמרים כפי שצוין קודם, וגם רכיבי iframe של צד שלישי לא מוצגים, כך שצריך לשמור באופן ידני רק את התוכן שמעבר לכך.
למדוד ביצועים
כדי למדוד מדדי ביצועים, כדאי לבדוק אם עדיף למדוד אותם על סמך זמן ההפעלה ולא על סמך זמן הטעינה של הדף שממשקי ה-API של הדפדפן ידווחו עליו.
המדדים הבסיסיים של חוויית המשתמש (Core Web Vitals) נמדדים על ידי Chrome באמצעות הדוח על חוויית המשתמש ב-Chrome, והם נועדו למדוד את חוויית המשתמש. לכן, המדדים האלה נמדדים על סמך זמן ההפעלה. לדוגמה, לעיתים קרובות זה יגרום ל-LCP של 0 שניות, מה שמראה שזו דרך מצוינת לשפר את ה-Core Web Vitals.
מגרסה 3.1.0, ספריית web-vitals עודכנה כדי לטפל בניווטים שעברו רינדור מראש באותו אופן שבו Chrome מודד את מדדי Core Web Vitals. הגרסה הזו גם מסמנת פעולות ניווט שרונדרו מראש במדדים האלה במאפיין Metric.navigationType אם הדף רונדר מראש באופן מלא או חלקי.
מדידת רינדורים מראש
כדי לראות אם דף רונדר מראש, אפשר לבדוק אם יש ערך שאינו אפס ב-activationStart של PerformanceNavigationTiming. לאחר מכן אפשר לתעד את המידע הזה באמצעות מאפיין מותאם אישית, או בדרך דומה כשמתעדים את הצפיות בדפים, למשל באמצעות הפונקציה pagePrerendered שמתוארת למעלה:
// Set Custom Dimension for Prerender status
gtag('set', { 'dimension1': pagePrerendered() });
// Initialise GA - including sending page view by default
gtag('config', 'G-12345678-1');
כך תוכלו לראות בניתוח הנתונים כמה פעולות ניווט רונדרו מראש בהשוואה לסוגים אחרים של פעולות ניווט, וגם לקשר בין מדדי ביצועים או מדדים עסקיים לבין סוגי הניווט השונים האלה. דפים מהירים יותר משפרים את חוויית המשתמש, ולעיתים קרובות יש לכך השפעה אמיתית על המדדים העסקיים, כפי שמוצג בתיאורי המקרה שלנו.
כשאתם מודדים את ההשפעה העסקית של עיבוד מראש של דפים לצורך ניווט מהיר, אתם יכולים להחליט אם כדאי להשקיע מאמץ רב יותר בשימוש בטכנולוגיה הזו כדי לאפשר עיבוד מראש של יותר ניווטים, או לבדוק למה הדפים לא עוברים עיבוד מראש.
מדידת שיעורי ההתאמה
בנוסף למדידת ההשפעה של דפים שהמשתמשים מבקרים בהם אחרי רינדור מראש, חשוב גם למדוד דפים שעוברים רינדור מראש אבל המשתמשים לא מבקרים בהם לאחר מכן. יכול להיות שאתם מבצעים יותר מדי רינדור מראש, ומשתמשים במשאבים חשובים של המשתמשים בלי להפיק מכך תועלת.
כדי למדוד את זה, אפשר להפעיל אירוע של Analytics כשכללי הספקולציה מוכנסים – אחרי שבודקים שהדפדפן תומך ברינדור מראש באמצעות HTMLScriptElement.supports('speculationrules') – כדי לציין שהתבקש רינדור מראש. (חשוב לזכור שגם אם נשלחה בקשה לרינדור מראש, זה לא אומר שהרינדור מראש התחיל או הושלם. כמו שצוין קודם, רינדור מראש הוא רמז לדפדפן, והוא יכול לבחור לא לרנדר מראש דפים על סמך הגדרות המשתמש, השימוש הנוכחי בזיכרון או שיטות היוריסטיות אחרות).
לאחר מכן תוכלו להשוות בין מספר האירועים האלה לבין הצפיות בפועל בדפים שרונדרו מראש. לחלופין, אפשר להפעיל אירוע אחר בזמן ההפעלה אם זה מקל על ההשוואה.
כדי לקבל הערכה של "שיעור ההיטים המוצלחים", אפשר לבדוק את ההבדל בין שני הנתונים האלה. בדפים שבהם אתם משתמשים ב-Speculation Rules API כדי לרנדר מראש את הדפים, אתם יכולים לשנות את הכללים בהתאם כדי לשמור על שיעור היט גבוה, וכך לאזן בין שימוש במשאבים של המשתמשים כדי לעזור להם לבין שימוש מיותר במשאבים.
חשוב לדעת שחלק מהרינדור מראש עשוי להתבצע בגלל הרינדור מראש של סרגל הכתובות, ולא רק בגלל כללי ההשערה. אם רוצים להבדיל בין המקרים, אפשר לבדוק את document.referrer (השדה הזה יהיה ריק בניווט מסרגל הכתובות, כולל ניווט מסרגל הכתובות שרונדר מראש).
חשוב לבדוק גם דפים שלא בוצע בהם רינדור מראש, כי זה יכול להצביע על כך שהדפים האלה לא כשירים לרינדור מראש, אפילו מסרגל הכתובות. זה אומר שיכול להיות שלא תיהנו מהשיפור הזה בביצועים. צוות Chrome שוקל להוסיף עוד כלים לבדיקת ההתאמה לרינדור מראש, אולי בדומה לכלי הבדיקה של bfcache, וגם להוסיף API שיחשוף את הסיבה לכך שהרינדור מראש נכשל.
ההשפעה על התוספים
בפוסט הייעודי בנושא תוספים ל-Chrome: הרחבת ה-API לתמיכה בניווט מיידי מפורטים שיקולים נוספים שיוצרי תוספים צריכים להביא בחשבון לגבי דפים שעברו עיבוד מראש.
משוב
צוות Chrome מפתח באופן פעיל את הרינדור מראש, ויש הרבה תוכניות להרחיב את היקף האפשרויות שהיו זמינות בגרסה 108 של Chrome. נשמח לקבל משוב במאגר GitHub או באמצעות Issue Tracker, ולשמוע ולשתף תיאורי מקרה של ה-API החדש והמלהיב הזה.
קישורים רלוונטיים
- Codelab בנושא כללי ספקולציות
- ניפוי באגים בכללי ספקולציות
- היכרות עם NoState Prefetch
- מפרט של Speculation Rules API
- מאגר GitHub של Navigational speculation
- תוספים ל-Chrome: הרחבת ה-API לתמיכה בניווט מיידי
תודות
התמונה הממוזערת צולמה על ידי Marc-Olivier Jodoin ופורסמה ב-Unsplash