

Puppeteer 及其选择器方法
Puppeteer 是一个适用于 Node 的浏览器自动化库,可让您使用简单、现代的 JavaScript API 控制浏览器。
最主要的浏览器任务当然是浏览网页。自动执行此任务基本上相当于自动执行与网页的互动。
在 Puppeteer 中,这是通过使用基于字符串的选择器查询 DOM 元素,并对这些元素执行点击或输入文本等操作来实现的。例如,打开 developer.google.com、找到搜索框并搜索 puppetaria 的脚本可能如下所示:
(async () => {
   const browser = await puppeteer.launch({ headless: false });
   const page = await browser.newPage();
   await page.goto('https://developers.google.com/', { waitUntil: 'load' });
   // Find the search box using a suitable CSS selector.
   const search = await page.$('devsite-search > form > div.devsite-search-container');
   // Click to expand search box and focus it.
   await search.click();
   // Enter search string and press Enter.
   await search.type('puppetaria');
   await search.press('Enter');
 })();
因此,如何使用查询选择器识别元素是 Puppeteer 体验的一个决定性部分。到目前为止,Puppeteer 中的选择器仅限于 CSS 和 XPath 选择器,虽然这些选择器在表达上非常强大,但在脚本中保留浏览器交互方面可能存在缺陷。
语法选择器与语义选择器
CSS 选择器本质上是语法性的;它们与 DOM 树文本表示的内部工作机制紧密相关,因为它们会引用 DOM 中的 ID 和类名。因此,它们为 Web 开发者提供了一个不可或缺的工具,用于修改页面中的元素或向其添加样式,但在这种情况下,开发者可以完全控制页面及其 DOM 树。
另一方面,Puppeteer 脚本是网页的外部观察者,因此,在此上下文中使用 CSS 选择器时,会引入有关网页实现方式的隐藏假设,而 Puppeteer 脚本无法控制这些假设。
其结果是,此类脚本可能很脆弱,容易受到源代码更改的影响。例如,假设有人使用 Puppeteer 脚本对某个 Web 应用进行自动化测试,该应用包含节点 <button>Submit</button>,它是 body 元素的第三个子元素。测试用例中的一个代码段可能如下所示:
const button = await page.$('body:nth-child(3)'); // problematic selector
await button.click();
在这里,我们使用选择器 'body:nth-child(3)' 来查找提交按钮,但这与此网页版本紧密绑定。如果稍后在按钮上方添加了元素,此选择器将不再有效!
这对测试编写者来说并不新鲜:Puppeteer 用户已经尝试选择能够应对此类更改的选择器。借助 Puppetaria,我们为用户提供了一个新工具。
Puppeteer 现在附带一个替代查询处理程序,该处理程序基于查询无障碍树,而不是依赖于 CSS 选择器。这里的基本理念是,如果我们想要选择的具体元素没有发生变化,那么相应的无障碍节点也不应该发生变化。
我们将此类选择器称为“ARIA 选择器”,并支持查询无障碍树的计算无障碍名称和角色。与 CSS 选择器相比,这些属性本质上是语义属性。它们不与 DOM 的语法属性相关联,而是描述如何通过屏幕阅读器等辅助技术观察页面。
在上面的测试脚本示例中,我们可以改用选择器 aria/Submit[role="button"] 来选择所需的按钮,其中 Submit 是指元素的无障碍名称:
const button = await page.$('aria/Submit[role="button"]');
await button.click();
现在,如果我们稍后决定将按钮的文本内容从 Submit 更改为 Done,测试将再次失败,但在这种情况下,这是我们希望看到的结果;通过更改按钮的名称,我们更改了页面的内容,而不是其视觉呈现方式或它在 DOM 中的结构。我们的测试应该会针对此类更改发出警告,以确保此类更改是有意为之。
回到带有搜索栏的更大示例,我们可以利用新的 aria 处理程序并替换
const search = await page.$('devsite-search > form > div.devsite-search-container');
,这可以通过
const search = await page.$('aria/Open search[role="button"]');
找到搜索栏!
更广泛地说,我们认为使用此类 ARIA 选择器可以为 Puppeteer 用户带来以下好处:
- 使测试脚本中的选择器更能适应源代码更改。
- 使测试脚本更易于阅读(无障碍名称是语义描述符)。
- 鼓励采用为元素分配无障碍属性的良好做法。
本文的其余部分将详细介绍我们如何实施 Puppetaria 项目。
设计流程
背景
如上所述,我们希望能够通过元素的无障碍名称和角色来查询元素。 这些是无障碍树的属性,无障碍树是常规 DOM 树的副本,供屏幕阅读器等设备用于显示网页。
从计算无障碍名称的规范来看,计算元素的名称是一项不简单的任务,因此我们从一开始就决定要为此重复使用 Chromium 的现有基础架构。
我们如何实施
即使仅限于使用 Chromium 的无障碍功能树,我们也可以通过多种方式在 Puppeteer 中实现 ARIA 查询。为了了解原因,我们先来看看 Puppeteer 如何控制浏览器。
浏览器通过名为 Chrome DevTools Protocol (CDP) 的协议公开调试接口。这会通过与语言无关的接口公开“重新加载页面”或“在页面中执行这段 JavaScript 并返回结果”等功能。
开发者工具前端和 Puppeteer 都使用 CDP 与浏览器通信。为了实现 CDP 命令,Chrome 的所有组件(浏览器、渲染器等)中都包含开发者工具基础架构。CDP 会负责将命令路由到正确的位置。
Puppeteer 操作(例如查询、点击和求值表达式)是通过利用 CDP 命令(例如 Runtime.evaluate)执行的,该命令直接在页面上下文中对 JavaScript 求值并返回结果。其他 Puppeteer 操作(例如模拟色觉缺陷、截取屏幕截图或捕获跟踪记录)则使用 CDP 直接与 Blink 渲染进程通信。
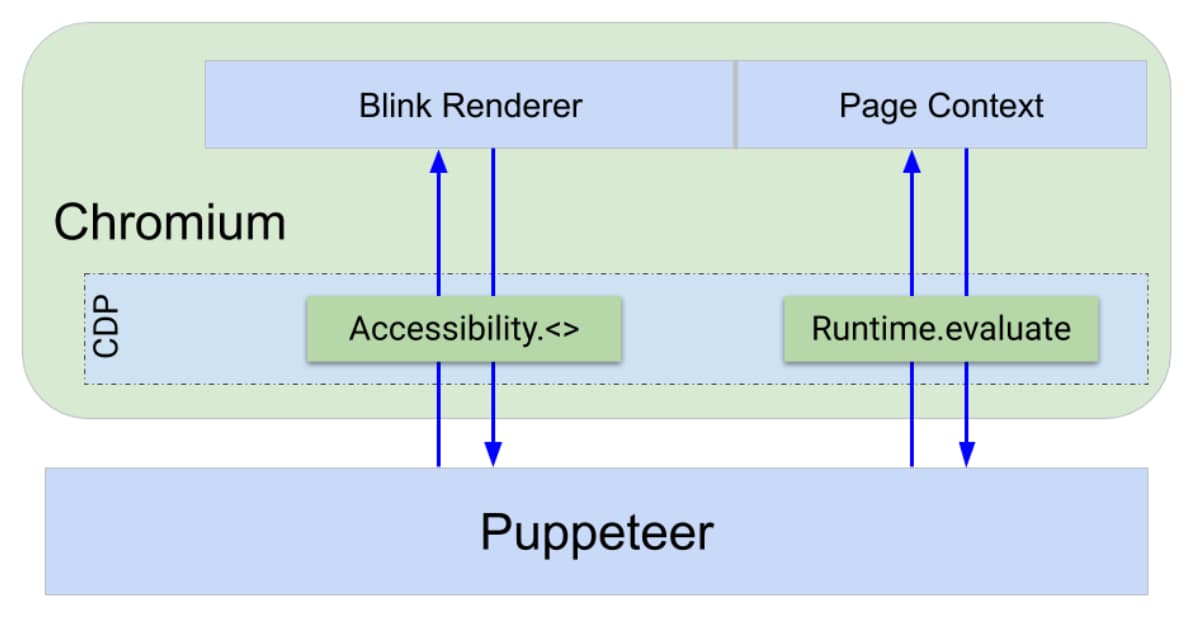
这已经为我们提供了两种实现查询功能的途径,我们可以:
- 使用 JavaScript 编写查询逻辑,并使用
Runtime.evaluate将其注入页面,或者 - 使用可直接在 Blink 进程中访问和查询无障碍树的 CDP 端点。
我们实现了 3 个原型:
- JS DOM 遍历 - 基于将 JavaScript 注入网页
- Puppeteer AXTree 遍历 - 基于使用现有 CDP 访问无障碍功能树
- CDP DOM 遍历 - 使用专为查询无障碍树而构建的新 CDP 端点
JS DOM 遍历
此原型会完整遍历 DOM,并使用 element.computedName 和 element.computedRole(由 ComputedAccessibilityInfo 发布标志控制)在遍历期间检索每个元素的名称和角色。
Puppeteer AXTree 遍历
在这里,我们改为通过 CDP 检索完整的无障碍功能树,并在 Puppeteer 中遍历该树。然后,生成的无障碍节点会映射到 DOM 节点。
CDP DOM 遍历
对于此原型,我们实现了一个新的 CDP 端点,专门用于查询无障碍树。这样,查询就可以通过 C++ 实现在后端进行,而不是通过 JavaScript 在页面上下文中进行。
单元测试基准
下图比较了 3 个原型查询 4 个元素 1,000 次的总运行时。该基准测试在 3 种不同的配置下执行,这些配置在页面大小以及是否启用无障碍元素缓存方面有所不同。

很明显,基于 CDP 的查询机制与仅在 Puppeteer 中实现的另外两种机制之间存在相当大的性能差距,并且相对差异似乎会随着页面大小的增加而急剧增加。有趣的是,JS DOM 遍历原型在启用无障碍缓存后,性能提升非常明显。停用缓存后,系统会按需计算无障碍树,并在每次互动后舍弃该树(如果停用了该网域)。启用该网域后,Chromium 会改为缓存计算树。
对于 JS DOM 遍历,我们在遍历过程中会请求每个元素的无障碍名称和角色,因此如果停用缓存,Chromium 会为我们访问的每个元素计算并舍弃无障碍树。另一方面,对于基于 CDP 的方法,只有在每次调用 CDP 之间(即针对每个查询)才会舍弃树。这些方法也受益于启用缓存,因为无障碍树会在 CDP 调用之间保留,但性能提升相对较小。
虽然在这里启用缓存看起来很理想,但它会增加内存用量。对于 Puppeteer 脚本(例如记录跟踪文件),这可能会导致问题。因此,我们决定默认不启用无障碍树缓存。用户可以通过启用 CDP 无障碍功能网域自行启用缓存。
开发者工具测试套件基准
之前的基准测试表明,在 CDP 层实现我们的查询机制可在临床单元测试场景中提升性能。
为了了解这种差异是否足够明显,以便在运行完整测试套件的更真实场景中引起注意,我们修补了 DevTools 端到端测试套件,以利用基于 JavaScript 和 CDP 的原型,并比较了运行时。在此基准测试中,我们总共将 43 个选择器从 [aria-label=…] 更改为自定义查询处理程序 aria/…,然后使用每个原型实现了这些选择器。
部分选择器在测试脚本中多次使用,因此在每次运行套件时,aria 查询处理程序的实际执行次数为 113 次。查询选择总数为 2253,因此只有一小部分查询选择是通过原型完成的。

如上图所示,总运行时长存在明显差异。数据过于杂乱,无法得出任何具体结论,但很明显,在这两种原型之间,性能差距在此场景中也同样存在。
新的 CDP 端点
鉴于上述基准,并且由于基于启动标志的方法通常不可取,我们决定继续实现一个新的 CDP 命令来查询无障碍树。现在,我们必须弄清楚这个新端点的接口。
对于 Puppeteer 中的用例,我们需要端点将所谓的 RemoteObjectIds 作为参数,并且为了使我们能够在之后找到相应的 DOM 元素,它应该返回一个包含 DOM 元素的 backendNodeIds 的对象列表。
如下图所示,我们尝试了多种满足此接口的方法。由此,我们发现返回对象的大小(即我们是返回完整的无障碍节点还是仅返回 backendNodeIds)并没有明显的差异。另一方面,我们发现使用现有的 NextInPreOrderIncludingIgnored 来实现遍历逻辑并不是一个好选择,因为这会导致明显的性能下降。

总结
现在,有了 CDP 端点,我们在 Puppeteer 端实现了查询处理程序。这里的主要工作是重构查询处理代码,使查询能够直接通过 CDP 解析,而不是通过在页面上下文中评估的 JavaScript 进行查询。
接下来怎么做?
新的 aria 处理程序作为内置查询处理程序随 Puppeteer v5.4.0 一起提供。我们期待看到用户如何将其应用到测试脚本中,并迫不及待地想听听您对如何使其更加实用的想法!
下载预览渠道
考虑将 Chrome Canary、开发者版或 Beta 版用作默认开发浏览器。通过这些预览渠道,您可以抢先体验最新的开发者工具功能、测试前沿的 Web 平台 API,并在用户发现问题之前及时发现网站上的问题!
与 Chrome 开发者工具团队联系
您可以通过以下方式讨论新功能、更新或与开发者工具有关的任何其他内容。
- 请通过 crbug.com 向我们提交反馈和功能请求。
- 在开发者工具中,依次点击 更多选项 > 帮助 > 报告开发者工具问题,即可报告开发者工具问题。
- 在 Twitter 上发帖并提及 @ChromeDevTools。
- 在“开发者工具的新变化”YouTube 视频或“开发者工具提示”YouTube 视频中发表评论。